Scaling Laws for Neural Language Models
论文链接:https://arxiv.org/pdf/2001.08361
代码链接:
摘要
我们研究了语言模型在交叉熵损失上的性能经验 scaling laws。损失随模型大小、数据集大小和训练计算量呈幂律增长,某些趋势跨越七个数量级以上。其他架构细节,例如网络宽度或深度,在较大范围内影响甚微。简单的方程描述了过拟合对模型/数据集大小的依赖性以及训练速度对模型大小的依赖性。这些关系使我们能够确定固定计算预算的最佳分配方案。更大的模型具有更高的样本效率,因此,最优的计算效率训练方案是在相对适中的数据集上训练非常大的模型,并在收敛之前显著停止训练。
1.Introduction
语言为人工智能的研究提供了一个天然的领域,因为绝大多数推理任务都可以用语言高效地表达和评估,而且世界上的文本为通过生成建模进行无监督学习提供了丰富的数据。近年来,深度学习在语言建模领域取得了快速进展,最先进的模型在许多特定任务上的表现已接近人类水平,包括生成连贯的多段落提示文本样本。
人们可能会认为语言建模的性能取决于模型架构、神经网络模型的规模、训练所需的计算能力以及可用于训练的数据量。本文将通过实证研究,探究语言建模损失对所有这些因素的依赖性,重点关注 Transformer 架构。由于 Transformer 架构在语言任务上的性能上限高、下限低,因此我们可以研究跨越七个数量级以上的趋势。
我们将观察到性能与训练时间、上下文长度、数据集大小、模型大小和计算预算之间存在精确的幂律缩放关系。
1.1 Summary
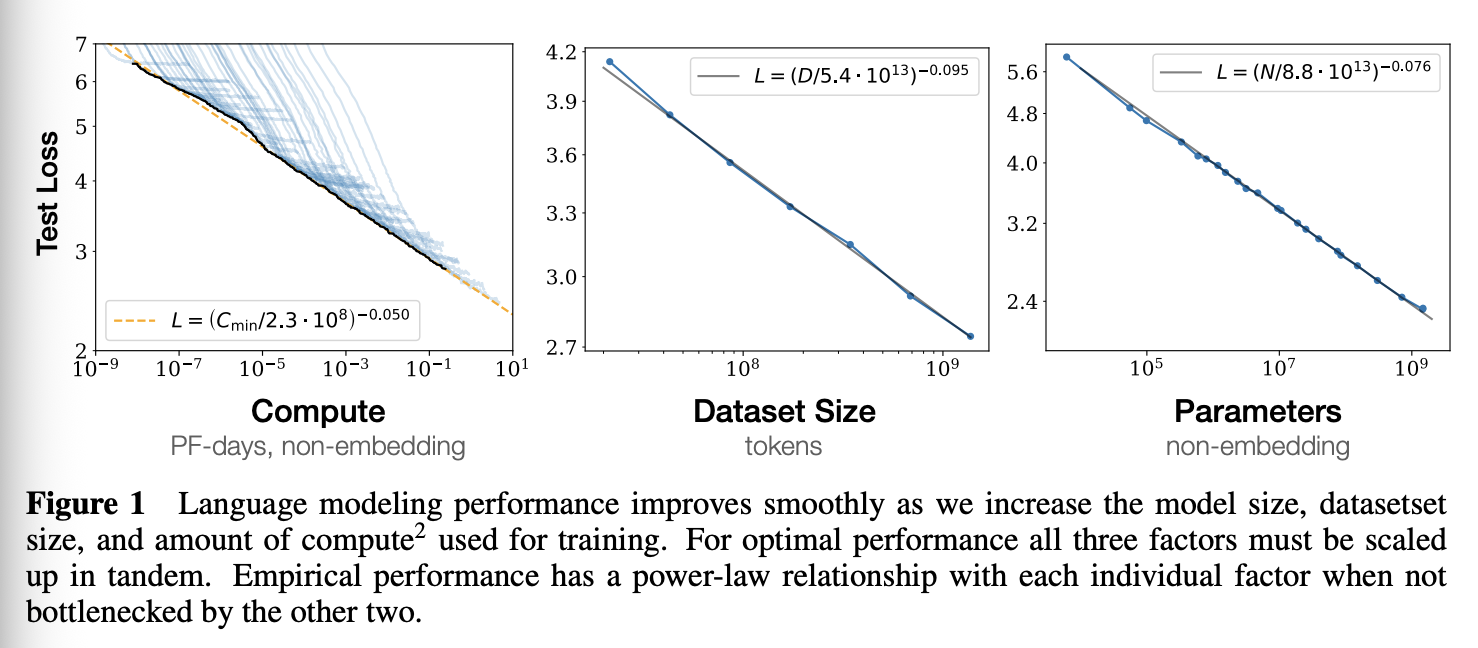
我们对 Transformer 语言模型的主要发现如下:
Performance depends strongly on scale, weakly on model shape。模型性能最主要取决于规模,规模由三个因素构成:模型参数数量 (不包括嵌入)、数据集大小 以及训练所用的计算量 。在合理的范围内,性能对其他架构超参数(例如深度与宽度)的依赖性很弱。(第 3 节)
Smooth power laws。当性能不受其他两个因素的制约时,性能与三个尺度因子 均呈幂律关系,其趋势跨越六个数量级以上(见图 1)。我们观察到,在性能上限范围内,没有出现偏离这些趋势的迹象,但性能最终必然会在达到零损失之前趋于平缓。(第 3 节)
Universality of overfitting。只要我们同时增加 和 ,性能就会按预期提升;但如果 N 或 D 保持不变而另一个增加,性能就会进入收益递减阶段。性能损失与 的比值成正比,这意味着每次我们将模型规模增加 8 倍时,只需将数据量增加大约 5 倍即可避免性能损失。(第 4 节)
Universality of training。训练曲线遵循可预测的幂律,其参数大致与模型规模无关。通过外推训练曲线的早期部分,我们可以大致预测如果训练时间更长将会达到的损失值。(第 5 节)
Transfer improves with test performance。当我们用与训练集分布不同的文本分布来评估模型时,结果与训练集和验证集上的结果高度相关,损失值存在大致恒定的偏移——换句话说,迁移到不同的分布会带来恒定的惩罚,但除此之外,性能的提升大致与训练集上的性能一致。(第 3.2.2 节)
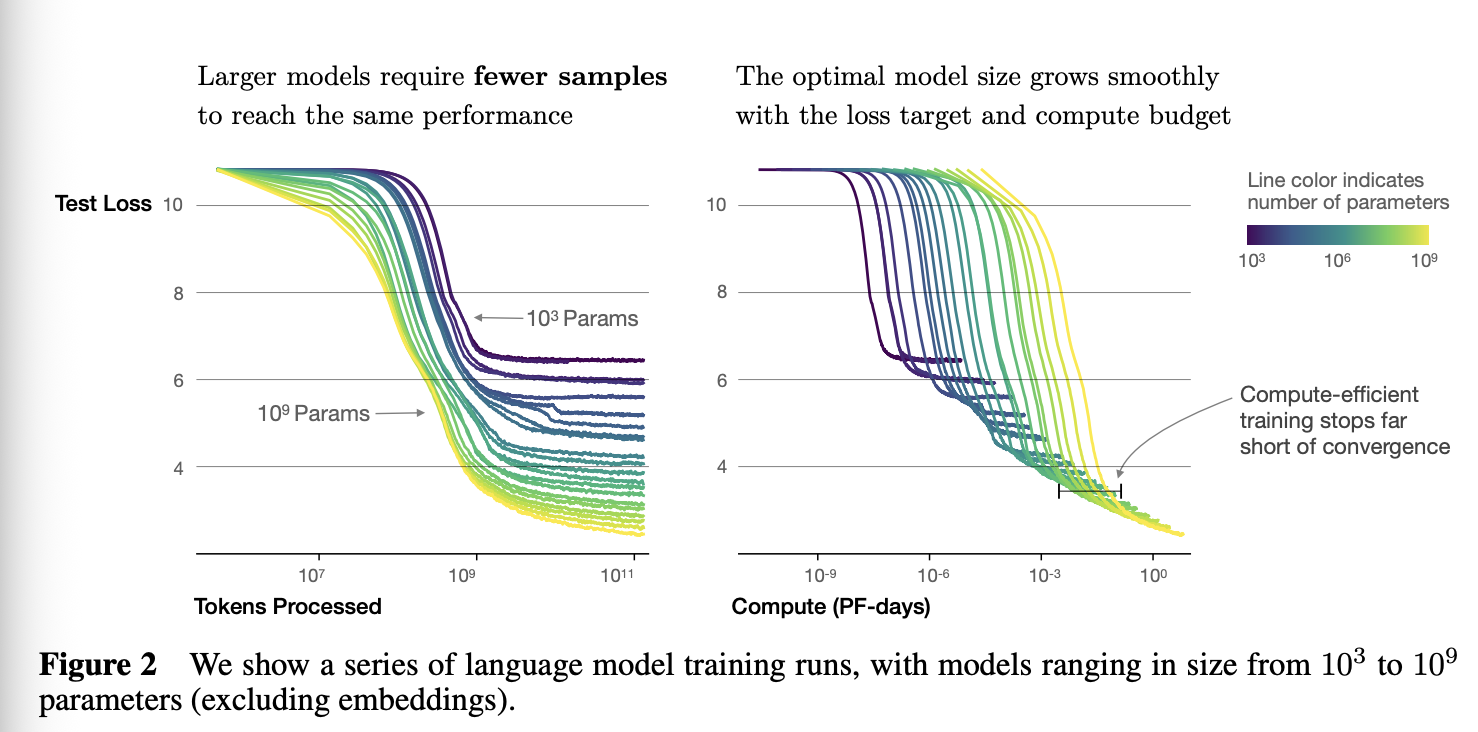
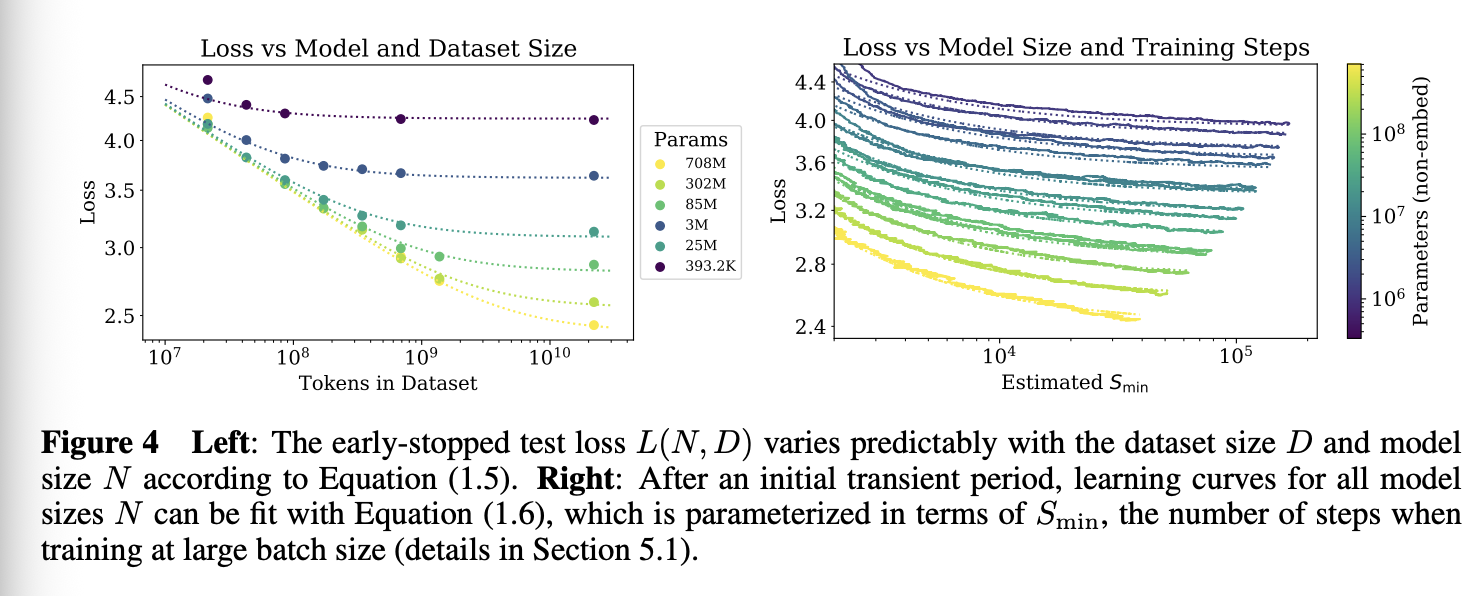
Sample efficiency。大型模型比小型模型更节省样本,只需较少的优化步骤(图 2)和较少的数据点(图 4)即可达到相同的性能水平。
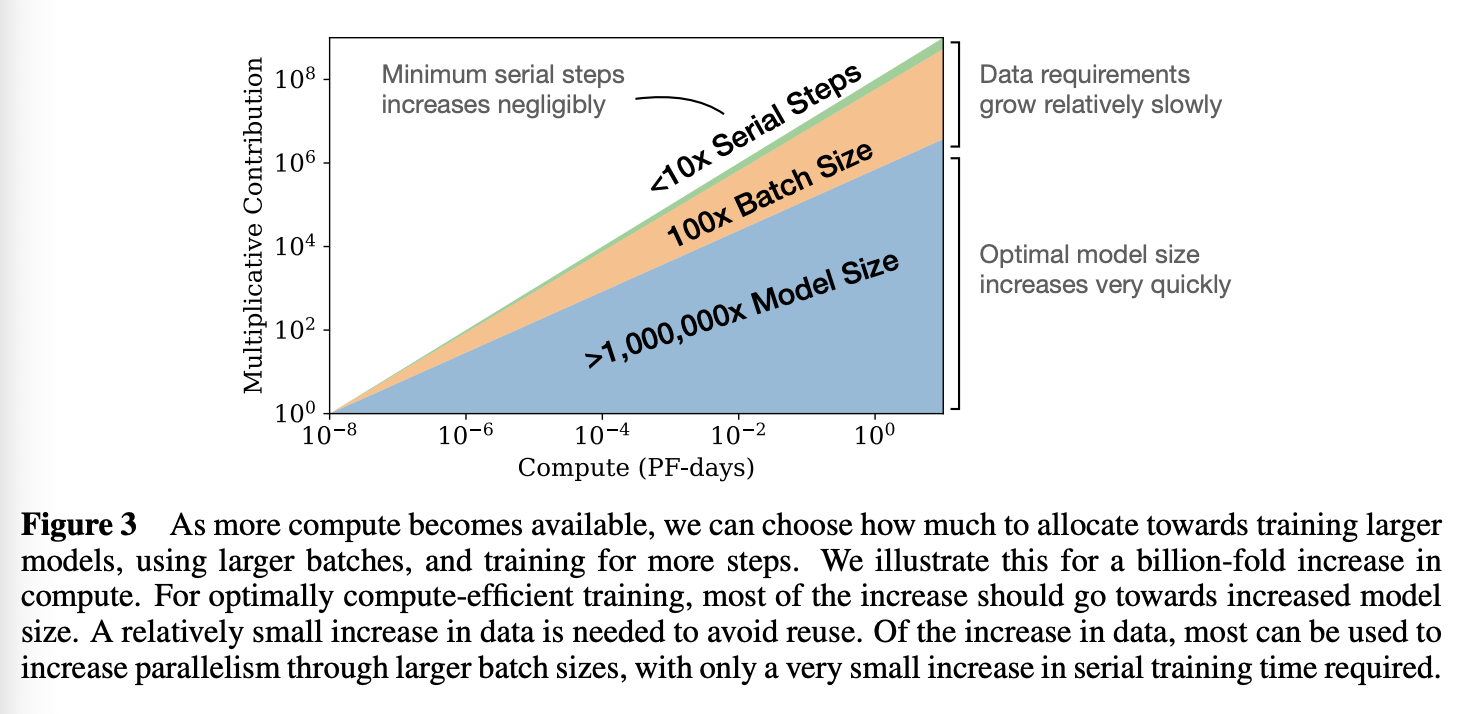
Convergence is inefficient。在计算预算 固定,且模型规模 或可用数据量 不受任何其他限制的情况下,我们通过训练非常大的模型并在远未达到收敛时停止训练来获得最佳性能(见图 3)。因此,最大程度提高计算效率的训练方法比基于训练小模型直至收敛的预期方法更节省样本,并且数据需求增长非常缓慢,因为 随训练计算量增加。(第 6 节)
Optimal batch size。训练这些模型的理想 batch size 大致是损失函数的幂,并且可以通过测量梯度噪声尺度来确定;对于我们能够训练的最大模型,收敛时大约需要 1~2M 个 token。(第5.1节)
综上所述,这些结果表明,随着模型规模、数据量和计算能力的适当扩展,语言建模性能能够平稳且可预测地提升。我们预期,规模更大的语言模型将比现有模型表现更佳,且样本效率更高。
1.2 Summary of Scaling Laws
当性能仅受限于非嵌入参数的数量 、数据集大小 或最优分配的计算预算 时,可以使用幂律来预测训练用于自回归建模语言的 Transformer 的测试损失(见图 1):
- 对于参数数量有限的模型,如果使用足够大的数据集进行训练以达到收敛,则适用以下情况:
- 对于使用有限数据集训练并采用提前停止策略的大型模型:
- 当使用有限的计算资源、足够大的数据集、最佳大小的模型和足够小的 batch size 进行训练时(充分利用计算资源):
这些关系在 的八个数量级、 的六个数量级以及 的两个数量级范围内都成立。它们对模型形状和其他 Transformer 超参数(深度、宽度、自注意力头数量)的依赖性很弱,其具体数值与 Webtext2 训练集相关联。幂律 分别表示随着 、 或 的增大,预期性能提升的程度;例如,参数数量翻倍会导致损失值减小 倍。、 和 的具体数值取决于词表大小和分词方式,因此没有根本意义。
决定数据并行速度/效率权衡的关键 batch size 也大致遵循 的幂律:
方程 (1.1) 和 (1.2) 共同表明,随着模型规模的增大,数据集规模应按 的亚线性关系增大。事实上,我们发现存在一个结合 (1.1) 和 (1.2) 的单一方程,该方程同时描述了模型规模对 和 的依赖性,并控制了过拟合的程度:
拟合结果如图 4 所示。我们推测,这种函数形式也可以参数化其他生成建模任务的训练对数似然函数。
在无限数据极限下,对给定模型进行有限次数的参数更新步骤 的训练时,经过初始瞬态期后,学习曲线可以精确拟合(见图 4 右侧)。
其中 且 , 是使用公式 (5.4) 估计的最小可能的优化步骤数(参数更新)。
当在固定的计算预算 C 内进行训练,且没有其他约束条件时,公式 (1.6) 预测最优模型大小 、最优 batch size 、最优步数 和数据集大小 应随时间增长。
并且
这与经验最优结果 、 和 非常吻合。随着计算预算 的增加,应主要用于构建更大的模型,而无需大幅增加训练时间或数据集大小(见图 3)。这也意味着,随着模型规模的增大,其样本效率也会提高。在实践中,由于硬件限制,研究人员通常会训练较小的模型,但训练时间会超过计算效率最大化所需的时间。最优性能与总计算量呈幂律关系(见公式 (1.3))。
我们为公式 (1.5) 提供了一些基本的理论推导,分析了学习曲线拟合及其对训练时间的影响,并逐个分析了每个 token 的结果。此外,我们还对 LSTM 和循环 Transformer 进行了一些简要比较。
1.3 Notation
我们使用以下符号:
- — 以 nats 为单位的交叉熵损失。通常情况下,它会在上下文中所有 token 上取平均值,但在某些情况下,我们也会报告上下文中特定 token 的损失。
- — 模型参数的数量,不包括所有词表和位置嵌入。
- – 表示非嵌入训练总计算量的估计值,其中 为 batch size, 为训练步骤数(即参数更新次数)。我们以 PF-day 为单位给出数值,其中 次浮点运算。
- – 数据集大小(以 token 为单位)
- — 临界 batch size,在5.1节中定义和讨论。使用临界 batch size 进行训练可以在时间和计算效率之间取得大致最优的平衡。
- ——达到给定损失值所需的最小非嵌入计算量的估计值。这是指如果模型训练的 batch size 远小于临界 batch size,则需要进行的训练计算量。
- — 达到给定损失值所需的最小训练步数的估计值。它也是当模型以远大于临界 batch size 的 batch size 进行训练时所需的训练步数。
- – 损失缩放的幂律指数,如 ,其中 可以是 中的任何一个。
2.Background and Methods
我们在 WebText2 数据集上训练语言模型。WebText2 是 WebText 数据集的扩展版本,使用字节对编码进行分词,词汇量为 。我们优化在 1024 个 token 上下文上平均的自回归对数似然损失(即交叉熵损失),这也是我们的主要性能指标。我们记录了 WebText2 测试分布以及其他一些文本分布上的损失。我们主要训练仅包含解码器的 Transformer 模型,但也训练了 LSTM 模型和 Universal Transformer 模型以作比较。
2.1 Parameter and Compute Scaling of Transformers
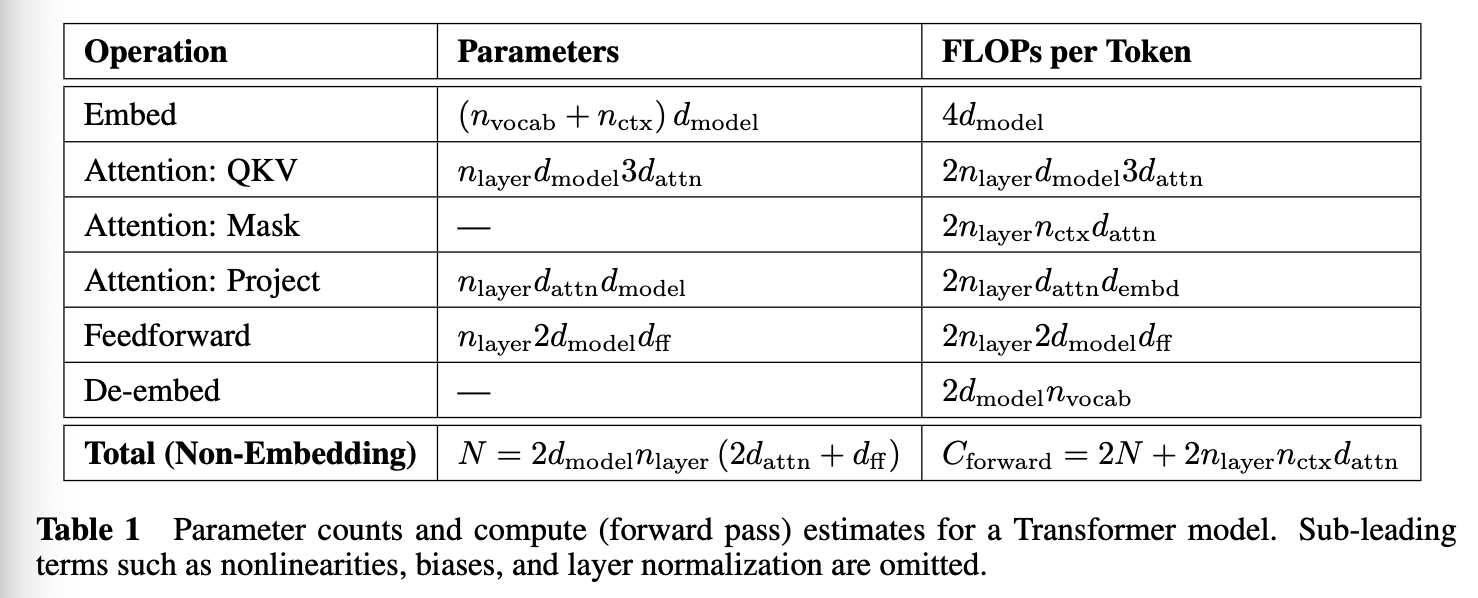
我们使用超参数 (层数)、(残差流的维度)、(中间前馈层的维度)、(注意力输出的维度)和 (每层的注意力头数量)对 Transformer 架构进行参数化。输入上下文中包含 个 token,除非另有说明,否则 。
我们用 表示模型规模,将其定义为非嵌入参数的数量。
我们已排除偏差和其他次要项。我们的模型在嵌入矩阵中也包含 参数,并使用 参数进行位置嵌入,但在讨论“模型大小” 时,我们不包含这些参数;我们将看到,这会产生更清晰的缩放律。
评估 Transformer 的前向传播大致需要
加法-乘法运算,其中系数 2 来自矩阵乘法中使用的乘加运算。表 1 中包含更详细的每次运算参数和计算次数。
对于 的上下文和模型,每个 token 的上下文相关计算成本仅占总计算成本的一小部分。由于我们主要研究 的模型,因此在训练计算量估算中不包含上下文相关项。考虑到反向传播(其计算量约为正向传播的两倍),我们将每个训练 token 的非嵌入计算量估计为 个浮点运算。
2.2 Training Procedures
除非另有说明,我们使用 Adam 优化器训练模型,固定训练步数为 ,batch size 为 个序列,每个序列包含 个 token。由于内存限制,我们使用 Adafactor 训练了参数超过 1B 的大型模型。我们尝试了多种学习率和学习率衰减策略,详见附录 D.6。我们发现,收敛时的结果与学习率衰减策略基本无关。除非另有说明,我们数据集中包含的所有训练运行均采用 3000 步线性预热后余弦衰减至零的学习率衰减策略。
2.3 Datasets
我们使用 [RWC+19] 中描述的 WebText 数据集的扩展版本来训练模型。原始的 WebText 数据集是从 Reddit 上抓取的截至 2017 年 12 月的出站链接,这些链接的 karma 值至少为 3。在第二个版本 WebText2 中,我们添加了 2018 年 1 月至 10 月期间的出站 Reddit 链接,同样 karma 值至少为 3。karma 值阈值用于判断用户是否认为链接有趣或有用。我们使用 Newspaper3k Python 库提取了新链接的文本。该数据集总共包含 20.3M 个文档,共计 96 GB 的文本,以及 个单词(根据 wc 的定义)。然后,我们应用 [RWC+19] 中描述的可逆分词器,生成 个 token。我们保留了 个这样的 token 作为测试集,我们还对类似准备的 Books Corpus、Common Crawl [Fou]、英文维基百科和一系列公开可用的互联网书籍样本进行了测试。
3.Empirical Results and Basic Power Laws
为了描述语言模型的扩展性,我们训练了各种各样的模型,并改变了包括以下几个因素在内的多种因素:
- 模型规模(非嵌入参数数量从 768M 到 1.5B 不等)
- 数据集大小(从 22M 到 23B 个 token 不等)
- 形状(包括深度、宽度、注意力头和前馈维度)
- 上下文长度(大多数情况下为 1024,但我们也尝试过更短的上下文)
- batch size(大多数情况下为 ,但我们也会改变 batch size 以测量临界 batch size)
本节将展示基于数据以及经验的拟合结果,理论分析将推迟到后面的章节进行。
3.1 Approximate Transformer Shape and Hyperparameter Independence
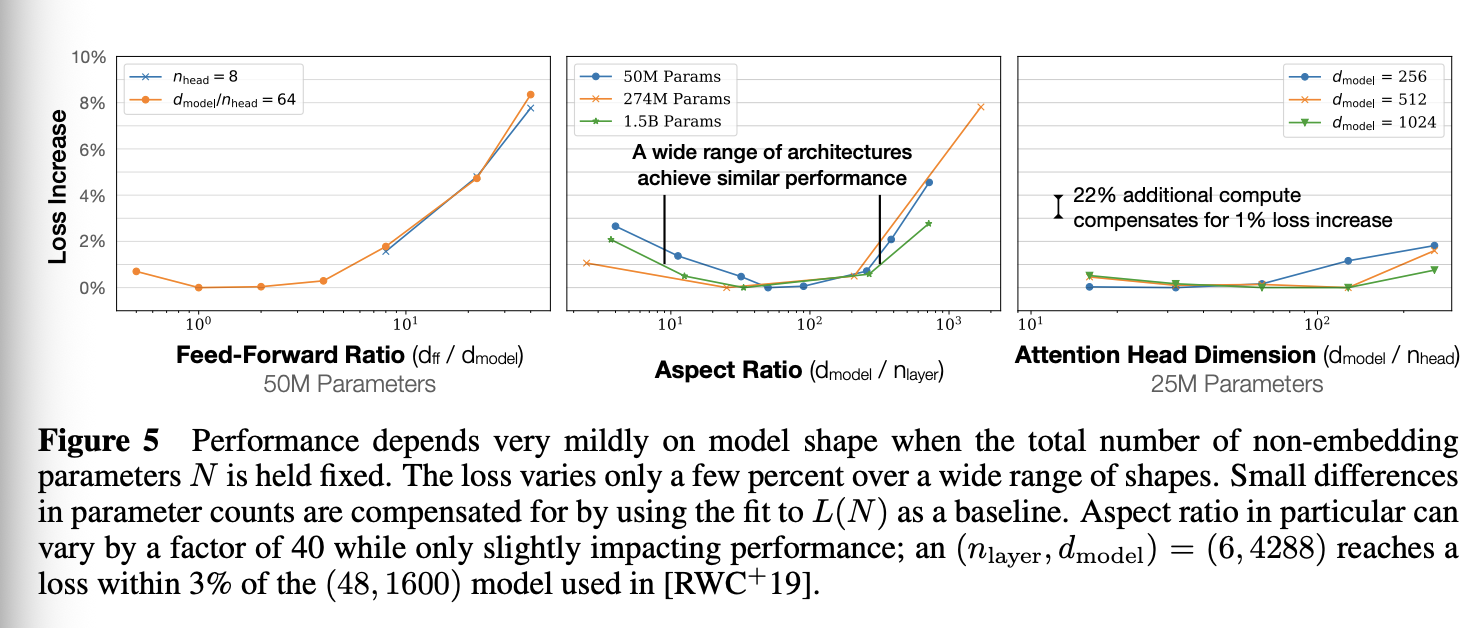
当总非嵌入参数 固定时,Transformer 的性能对形状参数 、 和 的依赖性很弱。为了验证这些结果,我们训练了大小固定的模型,同时改变单个超参数。对于 的情况,这最为简单。当改变 时,我们同时改变 ,并保持 不变。类似地,为了在模型大小固定的情况下改变 ,我们也同时改变 参数,正如表 1 中的参数计数所要求的那样。如果更深的 Transformer 能够有效地表现为较浅模型的集成(正如 ResNet 所提出的那样),那么 的独立性就成立。结果如图 5 所示。
3.2 Performance with Non-Embedding Parameter Count N
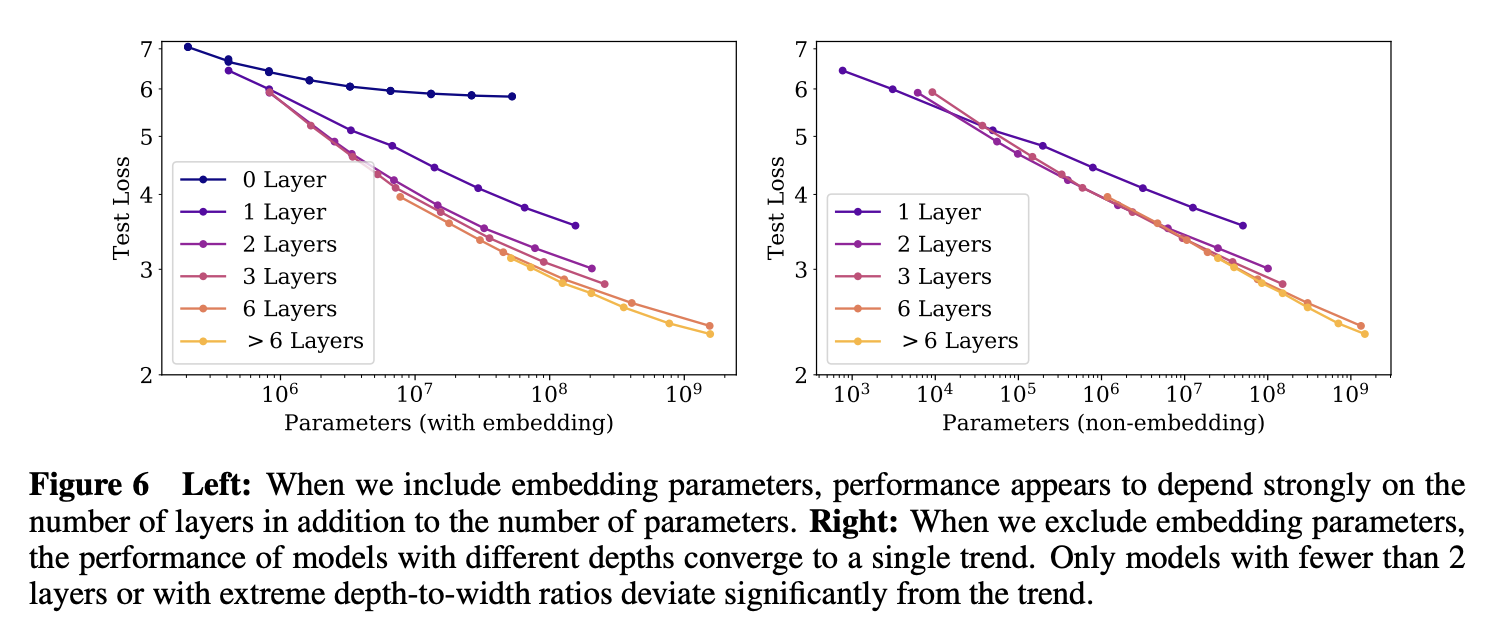
图 6 展示了各种模型的性能,从形状为 的小型模型到形状为 以及 的 1B 参数模型。我们已在完整的 WebText2 数据集上训练至接近收敛,并且未观察到过拟合现象(可能除了规模最大的模型外)。
如图 1 所示,我们发现非嵌入参数数量 呈现出稳定的趋势,这可以拟合方程 (1.5) 的第一项,因此:
为了观察这些趋势,研究性能与 的关系至关重要;如果我们使用参数总数(包括嵌入参数),则趋势会变得模糊不清(见图 6)。这表明,嵌入矩阵可以在不影响性能的情况下缩小,正如最近的研究 [LCG+19] 中所观察到的那样。
尽管这些模型是在 WebText2 数据集上训练的,但它们在各种其他数据集上的测试损失也是 的幂律,且幂次几乎相同,如图 8 所示。
3.2.1 Comparing to LSTMs and Universal Transformers
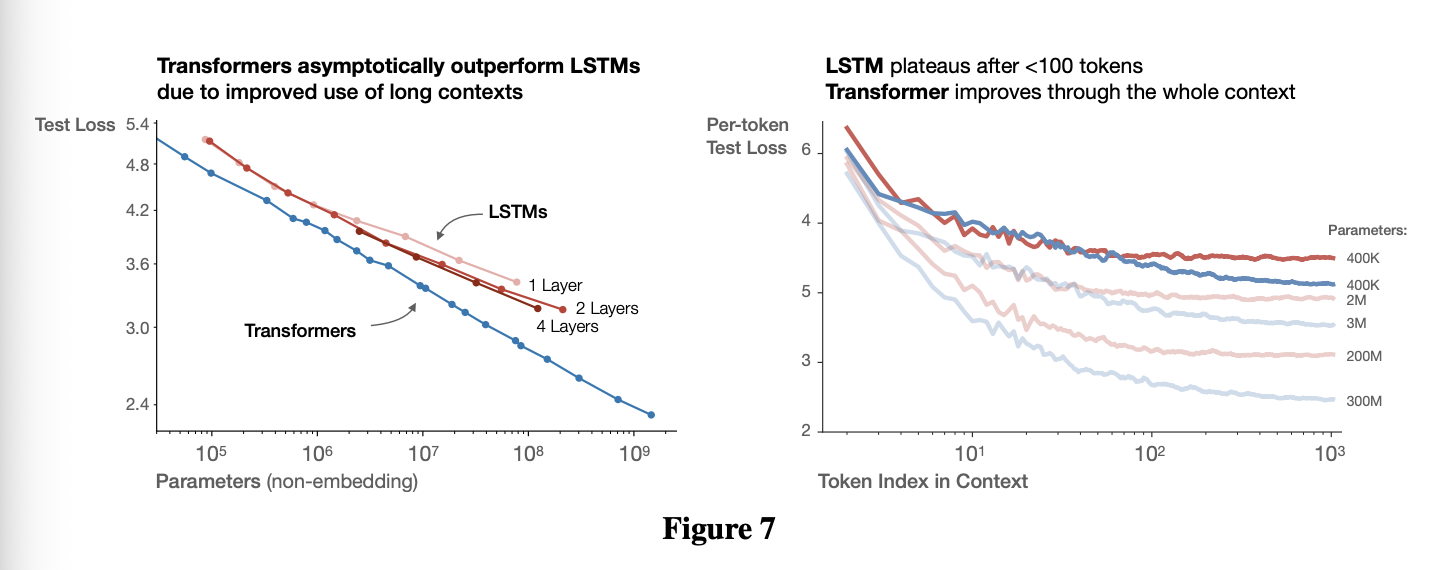
图 7 比较了 LSTM 和 Transformer 的性能与非嵌入参数数量 的关系。LSTM 使用相同的数据集和上下文长度进行训练。从图中可以看出,对于上下文中较早出现的 token,LSTM 的性能与 Transformer 相当,但对于上下文中较晚出现的 token,LSTM 的性能则不及 Transformer。我们在附录 D.5 中展示了性能与上下文位置之间的幂律关系,其中模型越大,幂指数越大,表明模型能够越快地识别模式。
我们在附录的图 17 中比较了标准 Transformer 模型和循环 Transformer 模型的性能。这些模型可以重用参数,因此性能会随着 的增大而略有提升,但代价是每个参数需要额外的计算量。
3.2.2 Generalization Among Data Distributions
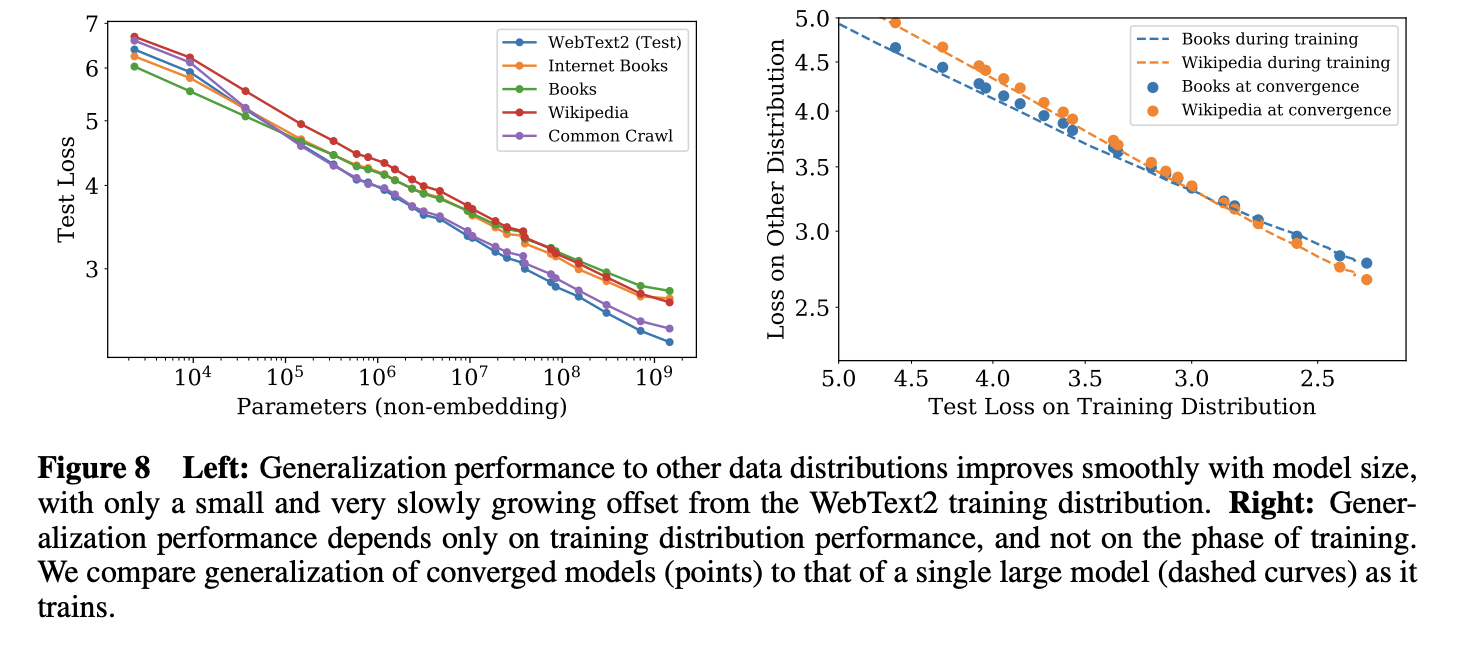
我们还使用一组额外的文本数据分布测试了我们的模型。图 8 显示了这些数据集上的测试损失随模型规模的变化;所有模型均仅使用 WebText2 数据集进行训练。我们可以看到,这些其他数据分布上的损失随着模型规模的增大而平滑改善,与 WebText2 上的改善完全一致。我们发现,泛化能力几乎完全取决于分布内验证损失,而与训练时长或收敛程度无关。我们也观察到模型深度与泛化能力无关(参见附录 D.8)。
3.3 Performance with Dataset Size and Compute
我们在图 1 中展示了测试损失随数据集大小 (以 token 为单位)和训练计算量 变化的函数的经验趋势。
为了研究 的趋势,我们使用 WebText2 数据集的固定子集训练了一个 的模型。当测试损失不再下降时,我们停止了训练。我们发现,得到的测试损失可以用简单的幂律函数拟合。
训练过程中使用的非嵌入计算总量可以估计为 ,其中 为 batch size, 为参数更新次数,系数 6 代表前向传播和反向传播。因此,对于给定的 值,我们可以遍历所有不同 值的模型,找到在步骤 时性能最佳的模型。需要注意的是,在这些结果中,所有模型的 batch size 保持不变,这意味着这些经验结果并非真正最优。我们将在后续章节中使用调整后的 来解决这个问题,从而获得更清晰的趋势。
结果在图 1 左侧图中以粗黑线表示。它可以用以下公式拟合:
图中还包含了各个模型的学习曲线图,以阐明各个模型何时达到最优状态。我们将在后续章节中更深入地研究计算资源的最优分配。数据有力地表明,样本效率随模型规模的增大而提高,我们在附录的图 19 中也直接展示了这一点。
4.Charting the Infinite Data Limit and Overfitting
在第 3 节中,我们发现了一些语言模型性能的基本缩放规律。在这里,我们将研究一个规模为 的模型在包含 个 token 的数据集上训练时的性能,同时改变 和 的值。我们将通过实验证明,最优训练后的测试损失符合公式 (1.5) 的缩放规律。这为我们提供了指导,帮助我们确定在控制过拟合的前提下,训练规模不断增大的模型需要多少数据。